Pourquoi mon site n'est pas indexé et comment y remédier
Si votre site n'est pas indexé, c'est que Google n'a pas pu explorer vos pages ou a choisi de ne pas les ajouter à son index — souvent à cause d'un fichier...
Si votre site n'est pas indexé, c'est que Google n'a pas pu explorer vos pages ou a choisi de ne pas les ajouter à son index, souvent à cause d'un fichier robots.txt trop restrictif, d'une balise noindex oubliée, d'un sitemap XML manquant ou erroné, ou d'un contenu jugé trop pauvre. L'indexation est la condition préalable à toute apparition dans les résultats de recherche: une page non indexée est invisible, quel que soit son potentiel de positionnement. Le diagnostic passe par Google Search Console, qui indique précisément la cause du blocage pour chaque URL.
Qu'est-ce que l'indexation Google et pourquoi est-elle essentielle pour votre visibilité?
L'indexation Google désigne l'étape où le moteur de recherche enregistre une page dans sa base de données, sans cette étape, aucune apparition n'est possible dans les résultats, même pour un contenu excellent.
Comprendre pourquoi mon site n'est pas indexé suppose de distinguer trois mécanismes distincts que beaucoup de propriétaires de sites confondent. D'abord, l'exploration (crawl): des robots appelés Googlebot parcourent le web pour découvrir les pages existantes. Ensuite, l'indexation: Google analyse le contenu exploré et décide de l'ajouter, ou non, à son index, une base de données gigantesque comparable au catalogue d'une bibliothèque [2]. Enfin, le classement (ranking): parmi les pages indexées, Google détermine celles qui méritent d'apparaître en tête pour une requête donnée. Ces trois étapes sont séquentielles, impossible de passer au classement sans indexation, et impossible d'être indexé sans avoir été exploré au préalable.
Comment Google lit et explore votre site web?
Googlebot découvre les pages d'un site principalement par trois voies: les liens internes qui relient les pages entre elles, le sitemap XML soumis via Google Search Console, et les liens externes provenant d'autres sites déjà connus de Google [3]. Une page orpheline, c'est-à-dire non reliée par aucun lien interne et absente du sitemap, a peu de chances d'être découverte, quelle que soit la qualité de son contenu. C'est pourquoi une architecture de site cohérente et un maillage interne soigné jouent un rôle direct dans la capacité de Google à localiser chaque page.
Quel est le lien entre l'indexation et l'apparition dans les résultats de recherche?
Une page peut être explorée par Googlebot sans jamais être indexée, Google visite le contenu, l'évalue, puis décide de ne pas l'ajouter à son index, souvent parce qu'il le juge dupliqué, trop pauvre ou de faible valeur [2]. À l'inverse, être indexé ne garantit aucun positionnement favorable: une page peut figurer dans l'index tout en restant reléguée en page dix des résultats. Ce qui reste absolu, en revanche, c'est l'absence totale de trafic organique pour une page non indexée [4]. Aucun volume de rédaction, aucune optimisation de mots-clés ne compense ce blocage initial, la page reste simplement invisible, un point que confirment plusieurs analyses de sites non indexés [1].
Pourquoi mon site n'est pas indexé: quels obstacles techniques bloquent Google?
La réponse à pourquoi mon site n'est pas indexé se trouve, dans la majorité des cas, dans un fichier de configuration mal réglé, un tag oublié ou une page trop lente à charger. Ces blocages sont souvent invisibles à l'œil nu tant qu'on n'a pas ouvert les bons outils de diagnostic.
Quels problèmes de fichier robots.txt, de sitemap XML ou de balises meta peuvent bloquer l'indexation?
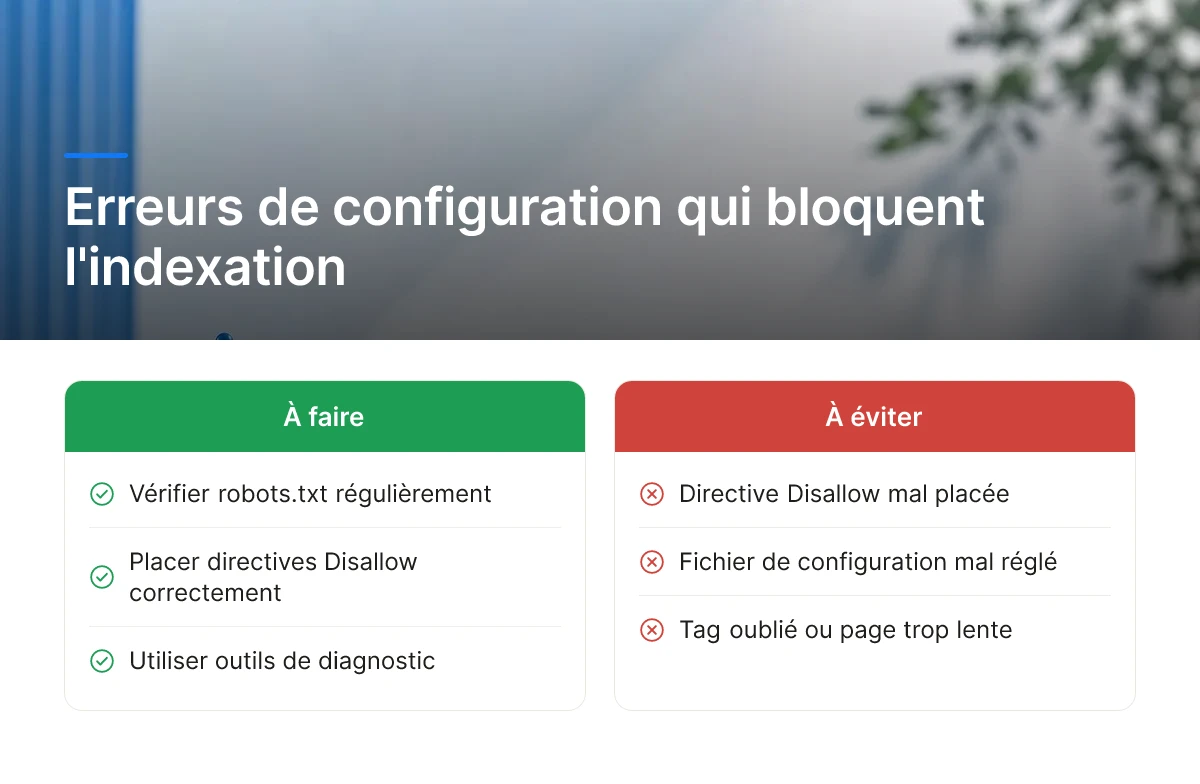
Trois erreurs de configuration reviennent constamment chez les sites invisibles sur Google.
- Une directive Disallow mal placée dans le robots.txt: une ligne censée bloquer un dossier technique finit parfois par interdire l'exploration de tout le site, souvent après une migration ou une refonte.
- Une balise meta noindex oubliée après une mise en ligne: les équipes techniques activent ce tag pendant le développement pour éviter que Google explore un site en construction, puis oublient de le retirer au lancement [3].
- Un tag canonical mal orienté: quand une page pointe vers une autre URL comme version de référence, Google indexe cette dernière et ignore la première, même si le contenu diffère [4].
Le sitemap XML joue aussi un rôle central dans la découverte des pages. Un sitemap mal formé, jamais soumis à la Search Console, ou encombré d'URLs obsolètes renvoyant des erreurs 404 ralentit la capacité de Google à repérer les nouvelles pages et à comprendre la structure du site [5].
Comment les Core Web Vitals et l'expérience utilisateur impactent-ils l'indexation en 2024-2025?
Un temps de chargement excessif ou une instabilité visuelle réduisent la fréquence de crawl et retardent l'indexation des nouvelles pages. Google explore les sites lents avec plus de prudence, en espaçant ses visites pour ne pas surcharger le serveur, ce qui allonge mécaniquement le délai avant qu'une page apparaisse dans les résultats. Sur un site e-commerce avec des centaines de fiches produits, ce ralentissement du crawl peut laisser des pages entières hors de l'index pendant des semaines.
Quels sont les problèmes hreflang et multilingues qui empêchent l'indexation des pages internationales?
Les balises hreflang mal implémentées empêchent Google d'associer correctement les versions linguistiques d'un même contenu. Les erreurs les plus fréquentes: des balises réciproques manquantes (la page française pointe vers la version anglaise, mais l'inverse n'est pas déclaré) et des codes de langue ou de région incorrects (confusion entre "fr" et "fr-FR", par exemple). Résultat: certaines versions internationales du site restent orphelines, non liées entre elles, et Google peine à décider laquelle indexer.
Enfin, le contenu dupliqué ou trop mince reste une cause fréquente de non-indexation même quand le crawl s'est bien déroulé. Google peut explorer une page sans jamais l'ajouter à son index s'il juge qu'elle n'apporte rien de nouveau par rapport à une page existante, sur le site ou ailleurs sur le web [2].
Comment vérifier si votre site est réellement indexé par Google?
Deux outils suffisent pour trancher: la commande de recherche site: pour un premier aperçu, et Google Search Console pour un diagnostic précis page par page. Avant de chercher pourquoi mon site n'est pas indexé, encore faut-il confirmer qu'il ne l'est vraiment pas, et sur quelles pages exactement.
Comment utiliser Google Search Console pour diagnostiquer les pages non indexées ou bloquées?
Le rapport Couverture (renommé "Pages" dans les versions récentes) de Google Search Console liste chaque URL connue de Google et son statut exact [2]. Deux libellés reviennent souvent chez les sites qui peinent à se faire indexer: "Explorée, actuellement non indexée" et "Détectée, actuellement non indexée" [4]. Le premier signifie que Googlebot a visité la page mais a choisi de ne pas l'ajouter à l'index, souvent un signal de contenu jugé trop faible ou dupliqué. Le second indique que Google connaît l'URL mais ne l'a pas encore explorée, généralement par manque de budget de crawl ou de liens internes pointant vers elle.
Pour un diagnostic ciblé sur une seule page, l'outil d'inspection d'URL, accessible en collant l'adresse dans la barre de recherche de Search Console, donne la raison précise fournie par Google: balise noindex détectée, page bloquée par le fichier robots.txt, redirection non résolue, ou erreur serveur au moment du crawl [3]. Cette fonction permet aussi de demander une exploration manuelle une fois le correctif appliqué, plutôt que d'attendre le prochain passage naturel de Googlebot.
Quels outils et commandes de recherche vous permettent de vérifier rapidement l'indexation?
La commande site:votredomaine.com tapée directement dans Google donne une estimation rapide du nombre de pages indexées [2]. Elle reste toutefois approximative: Google la présente comme une indication et non comme un décompte exhaustif, et les résultats peuvent varier d'une recherche à l'autre [1]. Elle sert surtout à repérer un problème massif, zéro résultat pour un site en ligne depuis plusieurs mois est un signal d'alerte clair.
En complément, plusieurs vérifications affinent le diagnostic: les extensions de navigateur qui affichent le code de statut HTTP et la présence d'une balise noindex en un clic, un outil de crawl simulant le parcours de Googlebot pour repérer les pages orphelines, et la comparaison directe entre le sitemap XML soumis et la liste des pages réellement indexées dans Search Console [5]. Un écart important entre ces deux listes pointe presque toujours vers un problème structurel, maillage interne insuffisant ou pages exclues par erreur, qu'il faudra corriger avant d'espérer une remontée dans les résultats.
Quelles sont les solutions concrètes pour faire indexer votre site et améliorer sa détection?
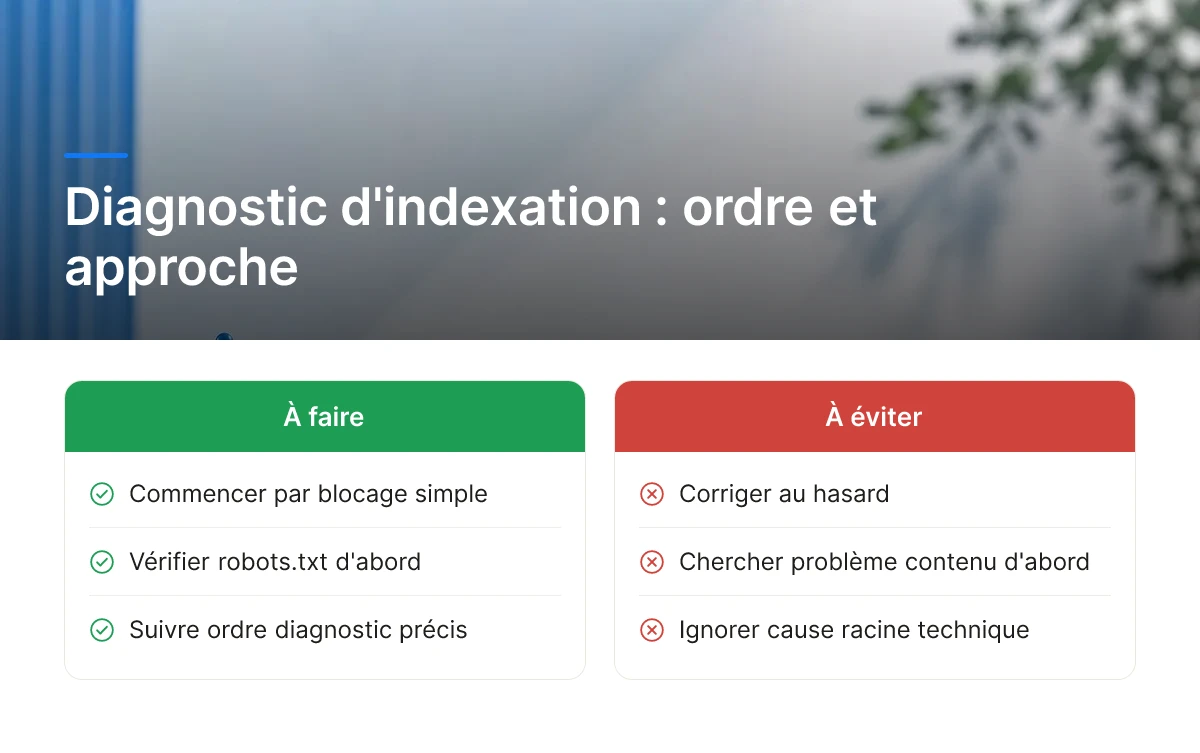
La correction passe par un diagnostic dans un ordre précis, puis par une soumission volontaire à Google, corriger au hasard fait perdre du temps et laisse souvent la cause racine intacte.
Quel est le diagnostic étape par étape pour identifier et corriger votre problème d'indexation spécifique?
Commencez toujours par le blocage le plus simple avant d'aller vers les explications plus complexes. Cet ordre évite de chercher un problème de contenu là où il s'agit en réalité d'une ligne oubliée dans un fichier technique.
- Robots.txt: vérifiez qu'aucune directive Disallow ne bloque les robots sur les pages concernées.
- Balises noindex: contrôlez le code source ou l'onglet Couverture de la Search Console pour repérer une balise meta robots ou un en-tête X-Robots-Tag mal configuré [4].
- Sitemap XML: assurez-vous que les URL manquantes y figurent bien et que le fichier ne renvoie pas d'erreur 404 ou 500.
- Qualité du contenu: une page trop fine, dupliquée ou proche d'une autre page du site peut être ignorée par Google, même sans blocage technique [3].
- Autorité du domaine: si tout le reste est correct, le manque de liens entrants ou de signaux de confiance peut expliquer une exploration lente ou partielle [2].
Répondre à la question pourquoi mon site n'est pas indexé demande donc de remonter cette liste étape par étape, sans sauter directement à l'hypothèse la plus rassurante.
Une fois la cause identifiée, corrigez le sitemap XML, retirez les URL erronées, ajoutez les pages manquantes, puis soumettez-le à nouveau depuis la Search Console. Utilisez ensuite l'outil d'inspection d'URL pour demander une exploration individuelle des pages prioritaires [5]. Cette demande ne garantit pas une indexation immédiate, mais elle accélère souvent le passage des robots sur les pages corrigées.
Comment corriger les erreurs de référencement naturel qui freinent l'apparition de votre site?
Trois leviers reviennent le plus souvent dans les audits: le maillage interne, le contenu dupliqué et la profondeur éditoriale. Une page isolée, sans lien interne pointant vers elle, envoie un signal de faible importance à Google [4]. Renforcer le maillage, depuis le menu, un article de blog ou une page catégorie, aide les robots à la découvrir plus vite.
Le contenu dupliqué, qu'il vienne de pages produit similaires ou de versions HTTP/HTTPS mal redirigées, dilue la valeur perçue de chaque page [3]. La faible profondeur de contenu, quelques lignes sans réponse claire à une intention de recherche, pousse Google à privilégier des pages concurrentes plus complètes.
Un audit technique complet reste nécessaire avant de conclure: corriger un symptôme visible sans traiter la cause racine mène souvent à revoir le même problème quelques semaines plus tard. Un outil comme Moonrank automatise une partie de ce diagnostic, détection des blocages robots.txt et noindex, suivi de la couverture d'indexation dans le temps, pour repérer les régressions avant qu'elles n'affectent le trafic.
Combien de temps faut-il pour qu'un site neuf soit indexé et comment accélérer le processus?
Un site neuf peut être indexé en quelques jours comme en plusieurs semaines, l'écart dépend surtout du sitemap, des premiers liens entrants et du rythme de publication.
Quels délais réalistes attendre et quelles actions prendre pour accélérer l'indexation?
Il n'existe pas de délai garanti, mais plusieurs facteurs jouent sur la vitesse de découverte par Googlebot. L'autorité du domaine compte: un site rattaché à une marque déjà connue ou hébergé sur un domaine ancien attire l'exploration plus vite qu'un nom de domaine tout juste enregistré [3]. La fréquence de publication influence aussi le passage des robots, qui reviennent plus souvent sur les sites actifs. Enfin, l'absence de sitemap.xml peut ralentir significativement l'indexation, car Google doit alors découvrir les pages uniquement via les liens, sans carte d'ensemble du site [4].
Face à ce constat, plusieurs leviers concrets accélèrent le processus. La soumission manuelle de l'URL via Google Search Console reste l'action la plus directe [2][5]. Obtenir de premiers liens entrants, même depuis un annuaire professionnel ou un partenaire, donne à Googlebot un chemin supplémentaire vers le site. Publier du contenu régulièrement signale une activité continue. Et un maillage interne construit dès la mise en ligne, reliant chaque nouvelle page aux pages existantes, évite les pages orphelines qui restent invisibles [3][4].
Comparez deux scénarios: un site neuf sans sitemap ni backlinks, qui dépend uniquement du passage aléatoire des robots, contre un site neuf avec sitemap soumis en Search Console et deux ou trois liens entrants dès le lancement. Le second profite d'un signal de découvrabilité renforcé et d'un chemin d'exploration balisé, ce qui réduit typiquement l'attente avant la première indexation.
Un fichier llms.txt complète désormais ce dispositif. Il ne remplace pas l'indexation Google, mais sert de signal supplémentaire pour les moteurs génératifs qui cherchent à comprendre la structure et le contenu d'un site. Cette question de pourquoi mon site n'est pas indexé se pose de plus en plus aussi pour les IA conversationnelles, pas seulement pour Google. Moonrank propose justement la génération et la maintenance d'un llms.txt, en complément de l'audit d'indexation classique, pour couvrir les deux fronts de découvrabilité.
Questions fréquentes
Une page peut-elle être explorée par Google sans être indexée?
Oui, c'est même une situation fréquente: Google visite la page (statut « Explorée, actuellement non indexée » dans Search Console) mais choisit de ne pas l'ajouter à son index. Cela arrive souvent quand le contenu est jugé trop mince, trop proche d'une autre page du site, ou peu pertinent par rapport à ce que Google connaît déjà du domaine.
Le contenu dupliqué peut-il empêcher l'indexation d'une page?
Oui, Google évite d'indexer des pages quasi identiques à d'autres, qu'elles proviennent du même site ou d'un site tiers [4]. Les fiches produit e-commerce reprenant les descriptions du fabricant, ou les variantes d'une même page dupliquées sur plusieurs URL, sont particulièrement exposées à ce filtrage.
Faut-il un sitemap.xml même pour un petit site vitrine?
Ce n'est pas obligatoire mais c'est recommandé, car un sitemap facilite la découverte des pages par les robots de Google [5]. Pour un site de quelques pages bien reliées entre elles par des liens internes, son absence pénalise rarement l'indexation. Il reste utile dès qu'on ajoute des pages ou qu'on veut accélérer leur découverte.
La demande d'indexation dans Search Console garantit-elle une indexation rapide?
Non, cette demande accélère parfois l'exploration mais ne garantit jamais l'indexation ni son délai [2]. Google reste libre d'ignorer la page si elle ne répond pas à ses critères de qualité ou d'unicité, quel que soit le nombre de demandes soumises.
Un site multilingue mal configuré en hreflang peut-il bloquer l'indexation de certaines langues?
Oui, des balises hreflang incorrectes créent de la confusion et peuvent empêcher certaines versions linguistiques d'être indexées correctement. Des retours croisés manquants, des codes de langue erronés ou des URL canoniques mal alignées font que Google indexe une seule version au détriment des autres, même quand tout le contenu existe bel et bien.

Conclusion
Un site non indexé résulte presque toujours d'un blocage identifiable: directive robots.txt trop restrictive, balise noindex oubliée après une mise en ligne, contenu jugé trop mince ou dupliqué, ou absence de liens internes vers les pages concernées. La priorité est de vérifier Search Console avant toute autre action, car le rapport de couverture indique précisément si Google a exploré, ignoré ou rejeté chaque page. Corrigez d'abord les blocages techniques, puis renforcez le maillage interne et la qualité éditoriale.
Pour aller plus vite, testez l'audit d'indexation de Moonrank: l'outil repère automatiquement les pages bloquées et priorise les corrections à fort impact.
Sources & References
- Pourquoi mon site n’apparaît pas sur Google?
- Pourquoi mon site n'est-il pas indexé?
- Pourquoi mon site n'apparaît pas sur Google?
- Site non indexé par Google: causes et solutions
- Pourquoi mon site n'est pas sur Google: 10 pistes à explorer - Redacteur Blog
Articles recommandés
Découvrez d'autres articles :