Comprendre le SEO pour les recherches par IA distribuée
Optimiser pour la recherche IA distribuée signifie adapter son contenu et son architecture technique à des systèmes qui n'interrogent pas un index central...
Optimiser pour la recherche IA distribuée signifie adapter son contenu et son architecture technique à des systèmes qui n'interrogent pas un index central unique, mais agrègent des résultats depuis plusieurs modèles ou nœuds répartis (recherche fédérée, apprentissage distribué). Concrètement, cela implique un balisage sémantique renforcé, une structure de données cohérente sur tous les points d'accès, et un contenu formulé pour répondre à des requêtes en langage naturel plutôt qu'à des mots-clés isolés. L'enjeu principal: rester visible quand aucune autorité centrale ne contrôle plus le classement.
Comment l'IA distribuée et les architectures décentralisées transforment-elles la recherche par rapport aux moteurs traditionnels?
Une architecture de recherche fédérée remplace l'index central unique par plusieurs nœuds qui traitent une requête localement, puis agrègent leurs résultats sans passer par un point de contrôle commun. C'est ce changement de mécanique qui redéfinit les règles du SEO recherche IA distribuée: il n'existe plus un seul algorithme à satisfaire, mais plusieurs logiques de traitement qui coexistent.
Qu'est-ce qu'une architecture de recherche fédérée et comment fonctionne le machine learning distribué dans ce contexte?
Dans un moteur classique comme Google, une requête interroge un index centralisé, construit à partir d'un crawl unifié et classé par un ensemble d'algorithmes partagés. Dans une architecture fédérée, plusieurs nœuds, parfois des modèles distincts, parfois des instances régionales ou spécialisées, traitent la même requête en parallèle, puis un mécanisme d'agrégation fusionne leurs réponses respectives.
Le apprentissage distribué (federated learning) accompagne ce changement côté entraînement des modèles. Plutôt que de centraliser toutes les données dans un seul entrepôt pour entraîner un modèle unique, chaque nœud entraîne sa propre version sur ses données locales, et seuls les paramètres du modèle, pas les données brutes, sont partagés et combinés. Concrètement, un contenu peut être "appris" différemment selon le nœud qui l'a rencontré en premier, avec quelles données voisines, et selon quelle pondération locale.
Pourquoi les moteurs de recherche décentralisés posent-ils des défis différents pour le référencement naturel?
L'absence d'autorité de classement unique complique la tâche parce qu'il n'y a plus une seule cible à optimiser, mais plusieurs systèmes de priorisation qui tournent en parallèle et n'appliquent pas nécessairement les mêmes critères. Un contenu bien structuré pour un nœud peut rester invisible pour un autre si son balisage, son contexte sémantique ou sa formulation ne correspondent pas aux signaux que ce nœud privilégie.
Prenons un exemple mécanique simple: une page produit e-commerce peut être interprétée comme hautement pertinente par un nœud entraîné sur des données transactionnelles récentes, tandis qu'un autre nœud, entraîné sur un corpus différent ou une fenêtre temporelle distincte, la classe plus bas parce qu'il pondère différemment la fraîcheur du contenu ou la densité des données structurées. La même URL, la même requête, deux résultats différents, sans qu'aucune erreur technique ne soit en cause. C'est la logique même du système qui produit cette variabilité, et c'est elle qu'une stratégie de SEO recherche IA distribuée doit anticiper plutôt que corriger après coup.
Quelles différences entre le SEO pour moteurs centralisés et la SEO recherche IA distribuée?
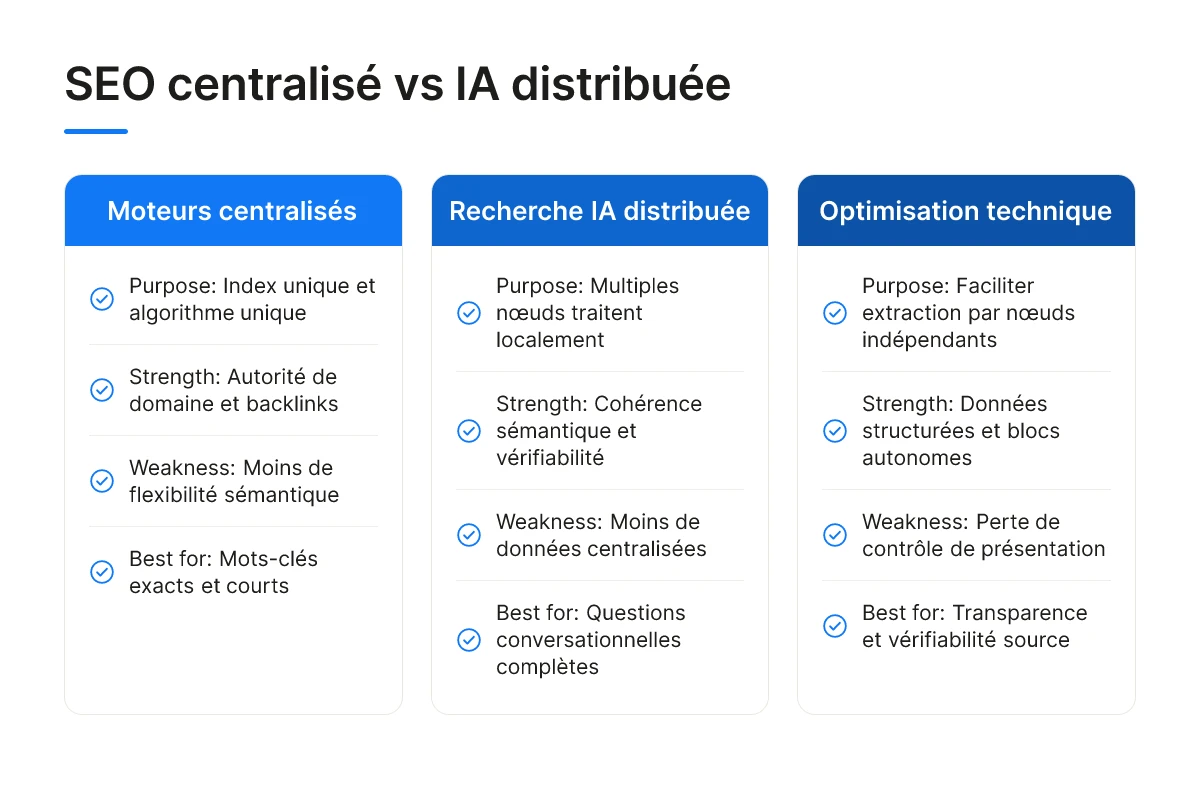
Le SEO classique classe des pages via des mots-clés exacts et des liens entrants; la SEO recherche IA distribuée évalue plutôt l'intention, la cohérence et la vérifiabilité d'un contenu à travers plusieurs sources indépendantes.
Un moteur centralisé comme Google construit un score unique par page, agrégé dans un index unique qu'il contrôle de bout en bout. Un système distribué, plusieurs modèles ou agents qui interrogent des sources différentes en parallèle avant de produire une réponse, ne cherche pas une page qui matche un mot-clé, il cherche une information qui se confirme ailleurs. Pour une marque e-commerce ou une agence qui gère plusieurs clients, cela change la cible: il ne s'agit plus d'optimiser une page pour ranker premier, mais de rendre un fait ou une caractéristique produit vérifiable sur plusieurs pages, plusieurs domaines, plusieurs formats.
Les backlinks restent un signal, mais leur poids relatif diminue face à un critère plus simple: est-ce que la même information apparaît, formulée différemment, sur des sources indépendantes? Un site avec un profil de liens modeste mais des données cohérentes sur sa propre page produit, sur des annuaires, sur des avis clients et sur une fiche établissement, devient plus citable qu'un site à forte autorité de domaine mais aux informations contradictoires d'une page à l'autre.
Comment adapter la recherche de mots-clés et l'optimisation du contenu pour les requêtes en langage naturel sur les systèmes distribués?
La recherche de mots-clés doit remplacer les requêtes courtes ("chaussures running femme") par des questions complètes ("quelles chaussures de running conviennent pour un semi-marathon sur route"). Les systèmes distribués traitent la requête comme une intention à satisfaire, pas une chaîne à faire matcher. Concrètement, cela veut dire structurer le contenu autour de questions entières, avec des réponses directes et vérifiables, plutôt que de multiplier les variantes d'un même mot-clé.
Quelles sont les spécificités du SEO conversationnel face aux systèmes de recherche décentralisés?
Le SEO conversationnel classique optimise une réponse pour un seul assistant qui interroge un index. Face à des systèmes décentralisés, plusieurs moteurs traitent la même question en parallèle et comparent les réponses entre sources avant de trancher, la cohérence inter-domaines devient donc un critère de sélection à part entière, pas seulement la qualité d'une page isolée. Moonrank (French) construit ses recommandations autour de cette logique multi-source, en identifiant les incohérences de contenu entre les canaux d'une marque avant qu'elles ne pénalisent sa visibilité.
Comment optimiser le contenu technique et la structure d'un site pour les moteurs de recherche IA décentralisés?
Un site prêt pour des architectures de recherche fédérées combine données structurées cohérentes, blocs de contenu autonomes, fichier llms.txt et sitemap à jour. Ces quatre éléments forment la base technique d'une stratégie de SEO recherche IA distribuée efficace, car chaque nœud d'indexation doit pouvoir comprendre une page sans dépendre du contexte global du site.
Quels signaux techniques et métadonnées sont prioritaires pour les systèmes de recherche fédérés?
Les données structurées au format schema.org restent le signal le plus fiable pour des nœuds d'indexation indépendants qui n'ont pas de vue d'ensemble du site. Un balisage Product, Article, FAQPage ou LocalBusiness cohérent sur toutes les pages permet à chaque agent de crawl de reconstruire le sens d'une page isolément, sans avoir besoin de visiter le reste du domaine.
La cohérence compte plus que la sophistication. Un site e-commerce qui balise ses fiches produit avec des attributs de prix, de disponibilité et de notation identiques d'une page à l'autre facilite l'extraction automatisée, même quand plusieurs systèmes distincts crawlent le site à des moments différents. À l'inverse, un balisage partiel ou incohérent entre catégories crée des trous que certains nœuds ne combleront jamais.
Le fichier llms.txt joue un rôle comparable à celui que jouait le sitemap.xml à ses débuts: un point d'entrée simple qui liste les ressources clés et leur fonction pour les agents IA. La quasi-absence de ce fichier sur la majorité des sites aujourd'hui constitue un frein concret à la découvrabilité, les agents doivent alors deviner la structure du site plutôt que la lire directement.
Comment structurer les données et le balisage sémantique pour une meilleure indexation par les architectures distribuées?
Chaque section de contenu doit avoir du sens hors contexte. Un système distribué peut extraire un seul bloc de texte sans jamais récupérer le paragraphe précédent ou suivant, donc une phrase comme "cette méthode fonctionne mieux" sans préciser laquelle devient inutilisable une fois isolée.
Concrètement, cela veut dire écrire des paragraphes qui se suffisent à eux-mêmes: nommer le sujet, poser le fait, éviter les renvois implicites ("comme vu plus haut"). Pour une agence gérant plusieurs sites clients, appliquer cette règle systématiquement demande une révision éditoriale, pas seulement un ajustement technique.
Un balisage hiérarchique clair, titres H2/H3 explicites, sections FAQ structurées avec balisage Question/Answer, facilite la fragmentation et la recomposition du contenu par des architectures décentralisées. Chaque titre doit résumer le contenu qui suit, car un modèle peut indexer un H3 et son paragraphe associé sans le reste de la page.
Enfin, un sitemap.xml tenu à jour accélère l'indexation quand plusieurs systèmes distribués crawlent le site indépendamment et à des rythmes différents. Sans sitemap fiable, chaque nœud redécouvre la structure du site à sa manière, ce qui multiplie les délais et les incohérences d'indexation entre systèmes.
Quels sont les enjeux de confidentialité et de sécurité des données pour la recherche IA distribuée?
La décentralisation réduit l'exposition des données personnelles mais prive aussi les praticiens SEO de la visibilité analytique agrégée dont ils dépendaient jusqu'ici.
Comment les systèmes de recherche décentralisés traitent-ils les données utilisateur et quelles implications pour l'optimisation SEO?
Dans une architecture fédérée, le modèle d'IA s'entraîne directement sur l'appareil ou le nœud local de l'utilisateur, sans jamais envoyer ses requêtes brutes vers un serveur central. Cette logique change la donne pour la confidentialité: les données de navigation, les historiques de recherche et les préférences restent physiquement proches de la source, ce qui limite les risques de fuite massive ou de profilage centralisé.
Pour un consultant SEO, cette architecture a un coût direct: moins de données agrégées disponibles pour comprendre comment les utilisateurs formulent leurs requêtes, cliquent, ou abandonnent une page. Les tableaux de bord classiques, construits sur des cohortes larges et des logs serveur centralisés, perdent une partie de leur pertinence quand une portion croissante des interactions se déroule localement, hors de portée des outils de mesure traditionnels.
Cette réalité oblige à repenser les méthodes de mesure pour le SEO recherche IA distribuée: tests A/B sur des échantillons volontaires, enquêtes déclaratives, ou analyse des citations obtenues dans les réponses IA plutôt que des seuls clics.
La tension entre personnalisation locale et contrôle éditorial
Un modèle local personnalise les résultats selon l'historique propre à chaque appareil, ce qui améliore la pertinence perçue mais réduit la capacité d'une marque à savoir comment son contenu apparaît réellement à l'utilisateur final. Deux personnes recherchant la même requête peuvent recevoir des réponses reformulées différemment, selon les préférences apprises localement par leur nœud.
Cette variabilité complique l'audit de visibilité: il devient difficile de garantir qu'un contenu est présenté fidèlement, avec les bonnes attributions et le bon contexte.
Face à cette perte de contrôle, la réponse qualitative prime sur le tracking comportemental. Structurer le contenu pour qu'il soit vérifiable, sources citées, données datées, auteurs identifiables, augmente les chances qu'un système distribué le retienne et le restitue correctement, même sans visibilité sur le nœud qui l'a consulté. Moonrank (French) construit ses recommandations autour de cette transparence des sources plutôt que sur des métriques de trafic devenues partielles par nature.
Retrouvez une méthode complète sur www.moonrank.ai.
Quels outils et métriques mesurent l'impact SEO sur les systèmes de recherche IA distribués?
Les métriques classiques, position moyenne, taux de clic, volume de trafic organique, ne suffisent plus à évaluer une stratégie de SEO recherche IA distribuée, car elles supposent un classement unique et stable qui n'existe pas dans ces environnements.
Métriques classiques vs métriques distribuées
Un classement Google se mesure en position sur une page de résultats. Une réponse générée par un système distribué se mesure autrement: à quelle fréquence votre marque est-elle citée, dans combien de réponses différentes apparaît-elle, et le nom, les chiffres ou les descriptions restent-ils cohérents d'une source à l'autre.
Ces trois indicateurs, fréquence de citation, présence dans les réponses générées, cohérence de la marque à travers plusieurs sources, remplacent progressivement le triptyque position/clic/impression pour les équipes qui pilotent leur visibilité sur des moteurs conversationnels ou fédérés.
Pourquoi le suivi manuel ne fonctionne plus
Vérifier une position Google à la main reste faisable: on ouvre une recherche, on regarde le rang. Vérifier la présence d'une marque dans les réponses de plusieurs modèles ou nœuds interrogés en parallèle ne l'est plus, parce que chaque requête peut produire une réponse différente selon le nœud sollicité, le contexte de la session ou la version du modèle.
Une agence qui gère dix clients ou une marque e-commerce présente sur plusieurs marchés ne peut pas multiplier les vérifications ponctuelles sans perdre en fiabilité. C'est ce qui pousse les équipes marketing vers des outils dédiés au suivi de visibilité IA, capables d'interroger systématiquement plusieurs systèmes et de consolider les résultats.
Les trois tiers d'outils disponibles
Le marché se structure en trois niveaux. En bas, des outils gratuits ou freemium permettent de tester ponctuellement si une marque apparaît dans une réponse IA, mais sans suivi dans le temps ni granularité par source. Au milieu, des solutions mid-range offrent un suivi régulier sur un nombre limité de requêtes et de moteurs. En haut, des plateformes premium spécialisées combinent suivi multi-source, alertes de cohérence de marque et analyse comparative face aux concurrents.
Comment suivre et analyser les performances de visibilité sur les moteurs de recherche IA décentralisés avec des outils comme Moonrank?
Moonrank répond à ce besoin en suivant la présence d'une marque à travers plusieurs moteurs et systèmes de génération de réponses, pas seulement le classement d'une page unique. La plateforme analyse la fréquence de citation, repère les incohérences entre les descriptions de marque selon les sources, et donne aux équipes marketing B2B, aux marques e-commerce et aux agences une vue consolidée là où le suivi manuel devient ingérable.
Pour évaluer concrètement votre visibilité sur ces systèmes distribués, la plateforme est accessible sur www.moonrank.ai.
Frequently Asked Questions
Qu'est-ce qu'une architecture de recherche fédérée?
Une architecture de recherche fédérée répartit l'indexation et l'inférence entre plusieurs nœuds ou agents plutôt que de tout centraliser sur un seul serveur. Chaque nœud traite une partie des requêtes ou des données, puis les résultats sont agrégés. Concrètement, un assistant IA peut interroger simultanément plusieurs bases de connaissances, moteurs spécialisés et sources web avant de composer une réponse, sans dépendre d'un index unique.
Le SEO traditionnel devient-il inutile face aux systèmes de recherche distribués?
Non, le SEO technique reste la base, structure du site, vitesse, balisage sémantique et autorité de contenu comptent toujours autant. Ce qui change, c'est la couche supplémentaire à gérer: la lisibilité machine du contenu pour des agents qui interrogent plusieurs sources en parallèle. Un site mal structuré techniquement restera invisible, quelle que soit l'architecture de recherche utilisée en aval.
Pourquoi un fichier llms.txt est-il utile pour la recherche IA distribuée?
Un fichier llms.txt donne aux agents IA un résumé structuré et priorisé du contenu du site, facilitant leur travail quand ils interrogent plusieurs sources à la fois. Dans un contexte distribué, où chaque nœud dispose d'un temps de traitement limité, ce raccourci augmente les chances qu'un contenu soit correctement interprété et cité plutôt qu'ignoré faute de clarté.
Comment savoir si mon site est visible sur des systèmes de recherche IA décentralisés?
Testez directement en interrogeant plusieurs assistants IA (ChatGPT, Perplexity, Claude) avec des requêtes liées à votre activité et vérifiez si votre marque apparaît dans les réponses ou citations. Complétez avec des outils de suivi de visibilité IA qui surveillent les mentions sur plusieurs moteurs simultanément, un site invisible sur un seul assistant peut très bien être cité par un autre, d'où l'intérêt de croiser les sources.

Conclusion
La recherche IA distribuée ne remplace pas les fondamentaux du SEO, elle les superpose à une nouvelle contrainte: rendre le contenu lisible et citable par des agents qui interrogent plusieurs sources en parallèle, pas un seul index centralisé. Trois actions concrètes ressortent: structurer le contenu avec un balisage sémantique clair, publier un fichier llms.txt pour guider les agents, et suivre la visibilité de la marque sur plusieurs assistants IA plutôt qu'un seul. Les équipes qui négligent cette couche multi-agents perdront en visibilité même avec un SEO technique solide. Comme prochaine étape, testez votre site sur www.moonrank.ai pour identifier les lacunes de visibilité IA avant qu'un concurrent ne les comble.
Articles recommandés
Découvrez d'autres articles :
- Le SEO contextuel au service de la compréhension sémantique
- Qu'est-ce que l'optimisation SEO pour les résultats IA ?
- Comprendre le SEO sémantique avancé au-delà des mots-clés
- Le Guide pour Réussir le SEO des Recherches d'IA Fédérées
- Le Guide du SEO pour les Recherches IA d'Entreprise